Et si le premier protocole METI n’était pas dirigé vers une étoile, mais vers une autre espèce terrestre ? Earth Species Project ne cherche pas seulement à reconnaître quelques cris animaux. L’organisation construit une infrastructure complète : rassembler et nettoyer des millions d’enregistrements, les annoter, apprendre des représentations acoustiques, comparer les modèles, identifier des motifs et, à terme, produire des vocalisations synthétiques dont la réception pourra être testée. Le message n’est plus lancé dans le silence cosmique : il revient vers nous sous la forme d’un comportement, d’une réponse ou d’un refus.
Cet article est distinct de celui consacre au diamant mandarin. Cette précédente étude portait sur une espèce, ses catégories d’appels et une expérience particulière d’apprentissage vocal. Ici, l’objet est l’infrastructure interspécifique : les outils ouverts, les jeux de données et les protocoles qui doivent fonctionner entre oiseaux, mammifères marins, primates, insectes ou amphibiens. NatureLM-audio en est le modèle phare, pas la totalité du projet.
1. Une chaîne d’écoute, pas un traducteur magique
La promesse populaire d’un « Google Translate des animaux » simplifie excessivement le problème. Avant de traduire, il faut savoir ce qui constitue une unité, qui l’émet, dans quelle situation, avec quelles variations et quels effets. Earth Species Project organise cette enquête en plusieurs couches. alp-data harmonise des collections hétérogènes ; Biodenoising sépare les sons biologiques du vent, des moteurs et des autres sources ; AVES apprend des représentations acoustiques ; Voxaboxen aide à annoter ; BEANS et BEANS-Zero évaluent les modèles ; NatureLM-audio relie enfin l’audio à des instructions et des réponses en langage naturel.
Cette architecture change l’échelle de la bioacoustique. Un laboratoire peut étudier un répertoire pendant des années avec quelques centaines d’heures soigneusement annotées. Un modèle fondation tente de transférer ce qu’il apprend d’un corpus à d’autres taxons, y compris des espèces absentes de l’entraînement. Le gain potentiel est immense pour la conservation ; le risque l’est aussi : une erreur peut se propager avec l’apparence de l’automatisation scientifique.
2. NatureLM-audio : un modèle fondation bioacoustique
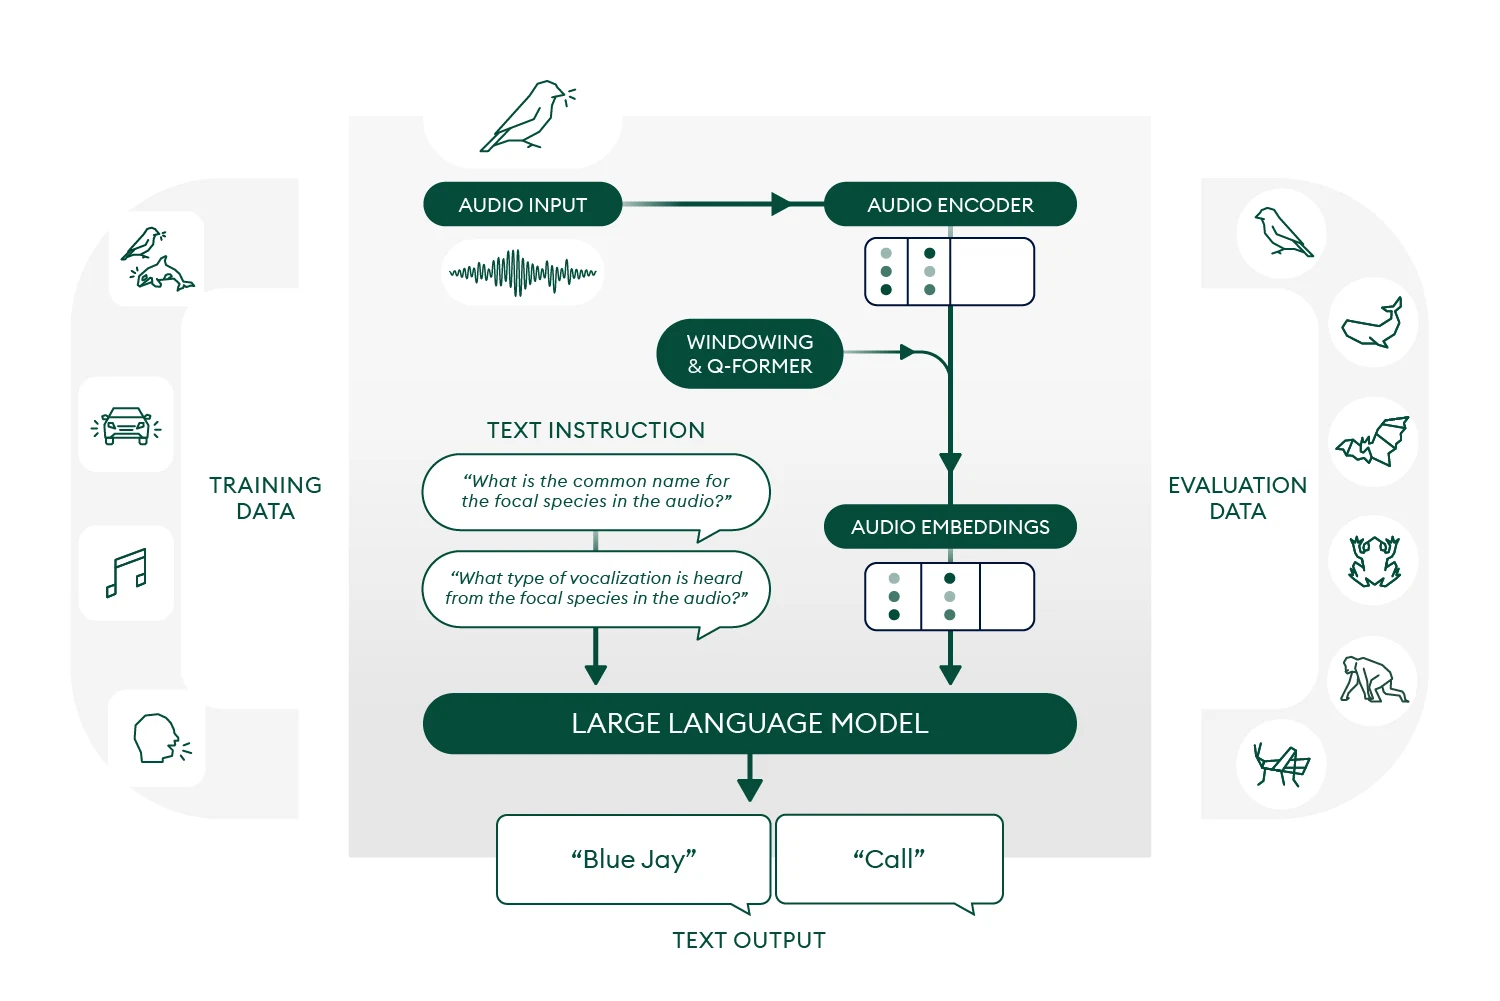
Présenté à ICLR 2025, NatureLM-audio est décrit par ses auteurs comme le premier modèle fondation audio-langage conçu spécifiquement pour la bioacoustique. Sa version documentée associe un encodeur audio BEATs affiné à un modèle Llama 3.1 8B Instruct. Elle a été entraînée sur plus de 26 millions de paires audio-texte provenant de sons animaux, mais aussi de parole et de musique. Ce mélange n’est pas anecdotique : il fournit des régularités acoustiques générales avant la spécialisation biologique.
Le modèle peut recevoir un extrait sonore et une question : quelle espèce entend-on, quel type de vocalisation, combien d’individus semblent présents, quel stade de vie est probable, ou comment décrire la scène acoustique ? Les évaluations montrent des capacités zero-shot, c’est-à-dire sans nouvel entraînement spécifique pour certaines espèces ou certains taxons. Mais « zero-shot » ne signifie ni infaillible ni universel : la qualité dépend du bruit, du domaine, de la rareté des appels et des biais du corpus.
3. Ce que le modèle sait, ce qu’il ne faut pas lui faire dire
La documentation officielle actuelle valide principalement l’identification et la détection d’espèces, le type d’appel ou de comportement vocal, le stade de vie, le comptage et la description. Elle signale aussi une limite concrète : l’adulte est mieux reconnu que le juvénile, dont le rappel est faible. Le stade de vie doit donc être utilise comme un indice souple, jamais comme une mesure certaine.
Certains jeux de données d’entraînement contiennent des métadonnées de sexe et de stade de vie. Cela ne suffit pas à affirmer que NatureLM-audio détermine de façon générale et robuste le sexe d’un animal à partir de n’importe quel son. Une telle inférence exige des validations par espèce, des individus connus et un contrôle des confusions entre sexe, âge, taille, contexte social et qualité du microphone. Cette nuance est centrale : l’IA produit une hypothèse quantifiée, pas l’identité intime de l’émetteur.
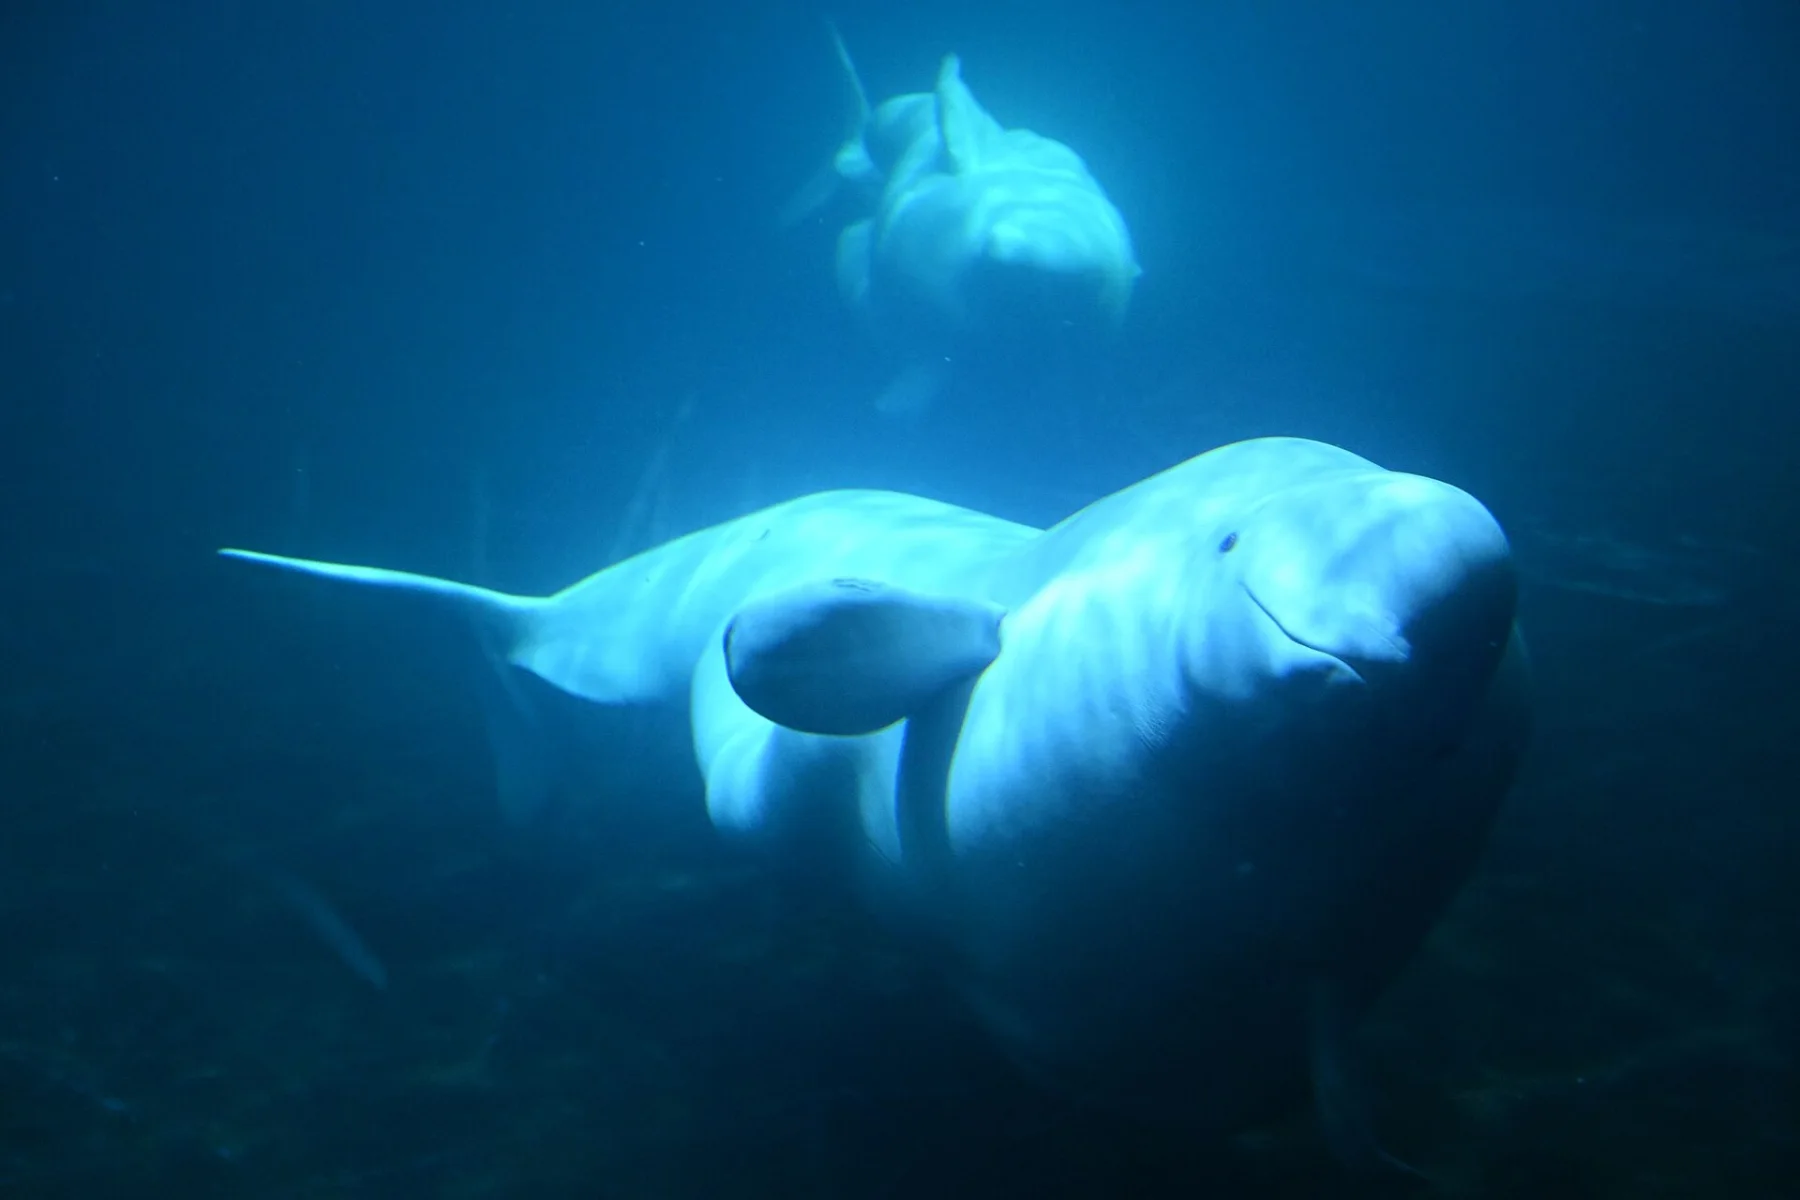
4. Le Saint-Laurent : cartographier les appels des belugas
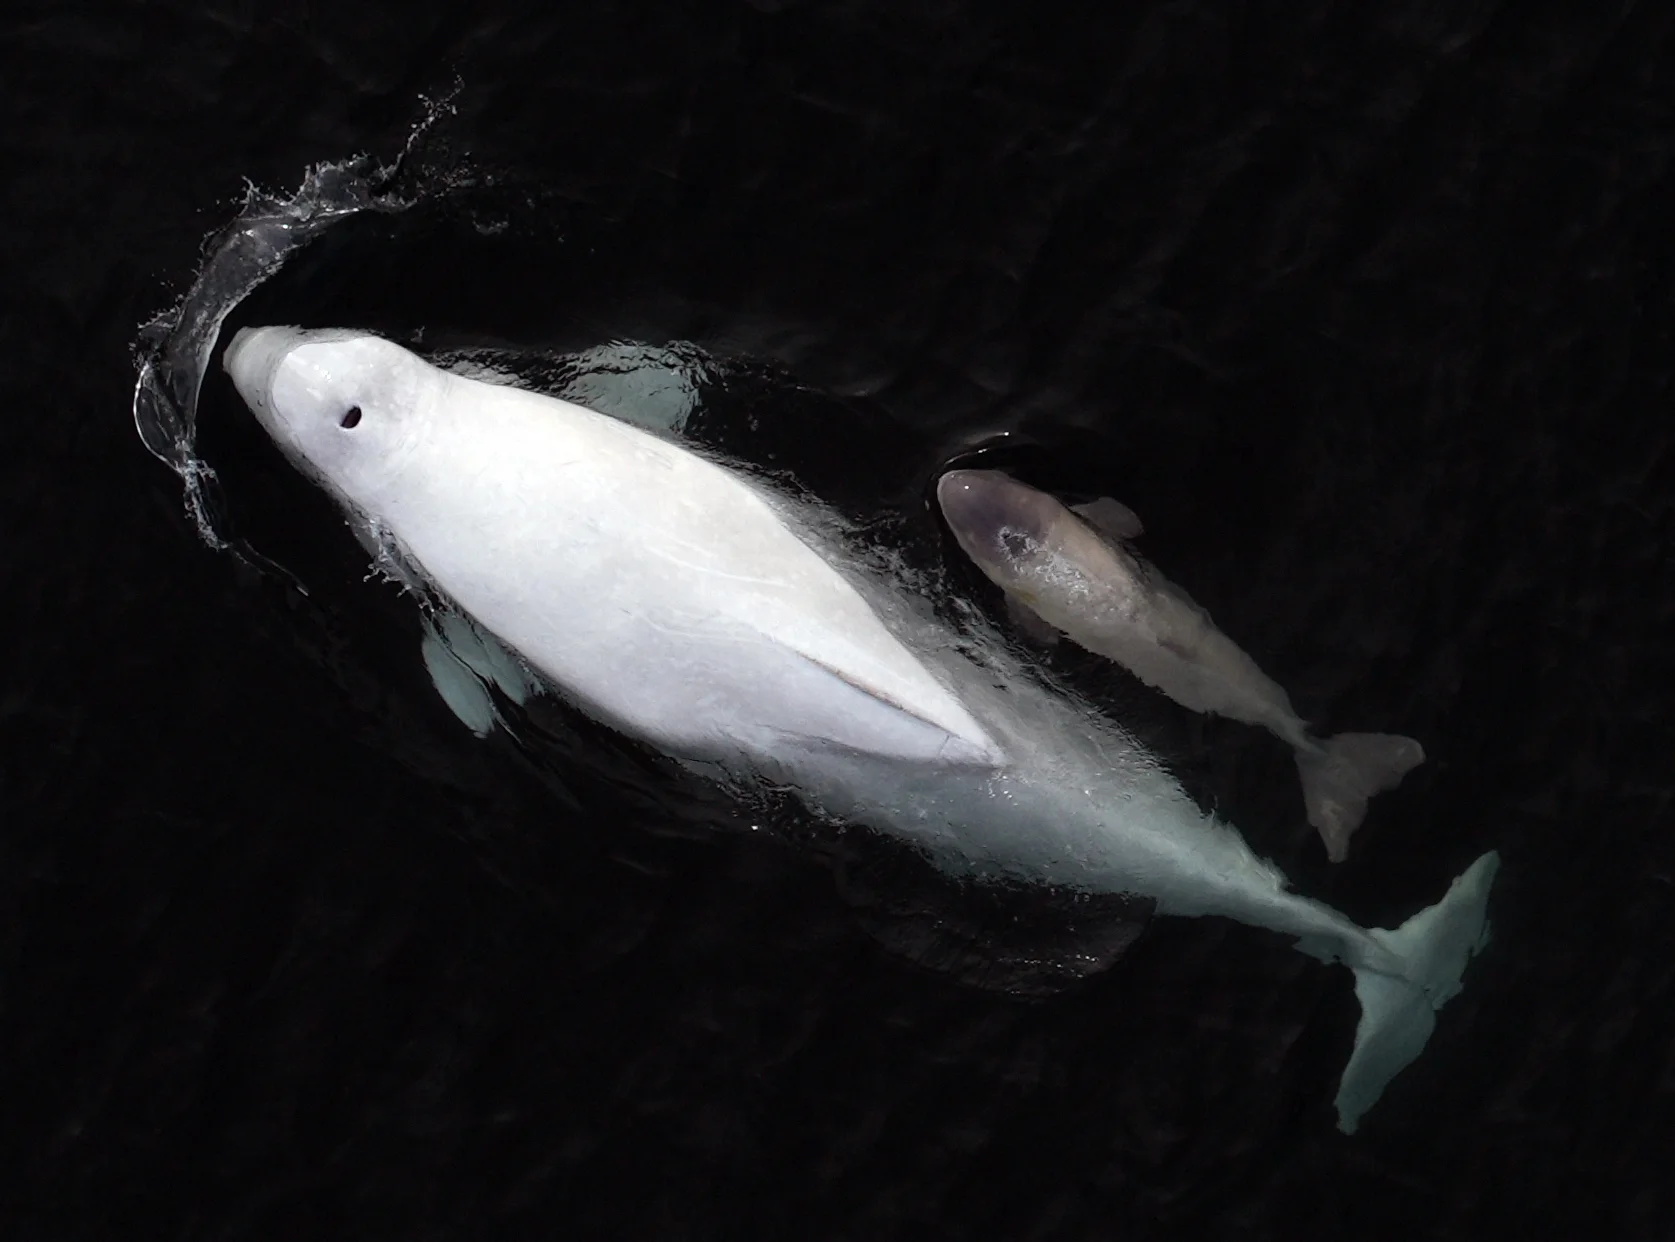
Les belugas sont parfois appelés « canaris des mers » en raison de leur riche répertoire. Leurs appels de contact peuvent porter une signature individuelle, maintenir la cohésion d’un groupe ou permettre à une mère et son petit de se retrouver. Avec la chercheuse Jaclyn Aubin, Earth Species Project utilise AVES pour mesurer les différences entre ces appels et les disposer dans un espace de similarité. Chaque point représente un son ; les amas indiquent des formes proches, sans constituer automatiquement des mots.
Le but est d’estimer la taille et l’organisation du répertoire, puis de relier les variations à l’identité, aux relations sociales, au lieu et au contexte. La question des dialectes devient alors testable. Les rapports canadiens notent que des répertoires vocaux peuvent aider à différencier des groupes de cétacés et que des types d’appels régionaux ont été observés. Mais les vocalisations forment souvent un continuum gradué : il faut une méthode robuste et des données comparables avant de conclure qu’une frontière acoustique correspond à une population ou à une culture.
5. Un dialecte n’est pas seulement une forme sonore
Deux groupes peuvent produire des appels différents pour plusieurs raisons : apprentissage social, adaptation au bruit local, isolement géographique, composition en âge, généalogie ou simple effet d’enregistrement. Pour parler de dialecte, le modèle acoustique doit rejoindre l’éthologie. Il faut suivre les individus, leurs déplacements, leurs liens, l’activité en cours et les conséquences de l’appel.
Cette exigence protège contre deux erreurs opposées. La première serait de réduire une culture animale à une courbe statistique. La seconde serait d’attribuer trop vite une syntaxe ou un lexique humain à toute structure. Une carte de points peut révéler une organisation inaccessible à l’oreille ; elle ne décide pas seule de ce que cette organisation signifie pour le beluga.
6. Incidences pour la conservation
Une infrastructure bioacoustique peut déjà agir sans « parler baleine ». Elle peut repérer une espèce dans des milliers d’heures, suivre des changements saisonniers, alerter des navires, identifier des zones de communication ou mesurer comment le bruit anthropique déforme les appels. Dans le Saint-Laurent, distinguer des répertoires peut aussi éclairer la structure sociale et les usages de l’habitat d’une population menacée.
Mais l’automatisation redistribue le pouvoir. Qui possède les archives sonores ? Une carte de présence peut-elle aider la protection tout en facilitant le repérage d’animaux vulnérables ? Les communautés autochtones, les chercheurs de terrain, les autorités et les riverains doivent-ils contrôler les usages ? Le modèle ouvert rend la science partageable ; il ne remplace pas une gouvernance des données et des interventions.
7. Décrire, prédire, puis générer
Le seuil suivant est la synthèse. Un modèle génératif pourrait produire une variation contrôlée d’un appel, puis un protocole de playback mesurerait la réponse : orientation, approche, éloignement, interruption, reprise vocale, imitation. On ne cherche pas d’abord à faire prononcer une phrase humaine. On teste si une population reconnaît une catégorie et quelles dimensions acoustiques portent cet effet.
Earth Species Project inscrit cette direction dans sa feuille de route : passer d’enregistrements rejoues à des signaux générés, plus nuances et potentiellement interactifs. C’est ici que l’analogie avec METI devient opérative. METI envoie un signal construit vers une intelligence non humaine dans l’espoir d’une réponse. Le playback génératif fait de même, mais le destinataire partage notre biosphère et les effets sont immédiats.
8. Le risque commence quand l’autre répond
Un appel synthétique peut tromper, stresser, interrompre l’alimentation ou la reproduction. Si le signal est socialement appris, une nouveauté pourrait se diffuser et modifier une culture. La feuille de route d’ESP reconnaît ces risques et propose de commencer dans des conditions contrôlées, avec biologistes, éthiciens et dispositifs de gouvernance. La capacité technique de produire un son plausible n’autorise pas son émission dans une population sauvage.
Un protocole responsable exige donc des seuils d’arrêt, une exposition minimale, des groupes de contrôle, une surveillance multimodale et la publication des résultats négatifs. Il doit distinguer une réponse d’orientation d’une compréhension. Surtout, il doit accepter que l’absence de réponse puisse être une information et non une invitation à augmenter le volume.
9. Projection A.L.I : le METI terrestre
Fait documente : NatureLM-audio classe et décrit des sons bioacoustiques ; AVES aide à cartographier des appels ; les playbacks sont une méthode établie pour tester des réactions.
Objectif de recherche : produire des vocalisations synthétiques contrôlées et évaluer si elles déclenchent des réponses spécifiques, sans confondre réaction et traduction.
Projection A.L.I : traiter cette boucle comme un METI terrestre, c’est-à-dire comme une diplomatie expérimentale avec une intelligence dont le monde perceptif, les catégories et les intérêts ne sont pas les nôtres.
A.L.I pourrait formaliser une séquence en sept étapes : écouter avant d’émettre ; situer chaque signal dans son contexte ; mesurer l’incertitude ; générer une variation minimale ; tester à faible intensité ; observer plusieurs modalités ; interrompre des qu’un coût comportemental apparaît. Cette méthode vaut aussi pour le contact interstellaire : ne pas prendre la détection pour la compréhension, ni la puissance d’émission pour une légitimité.
10. Une expérience possible : le miroir acoustique
Imaginons un système qui n’imite pas un appel complet, mais modifie une seule dimension d’un appel de contact connu : contour, rythme, intervalle ou timbre. Le dispositif compare la réaction à l’original, à la variation et à un contrôle acoustique. S’il observe une réponse stable, il affiné la carte de ce que les animaux considèrent comme invariant. La première « conversation » serait alors une série de questions sans mots : ceci est-il encore le même appel ? cette variation désigne-t-elle encore le même individu ? à quel moment le signal devient-il autre ?
Ce miroir ne prétend pas traduire. Il apprend les frontières perceptives de l’autre en rendant chaque hypothèse falsifiable. C’est peut-être la le geste le plus juste pour A.L.I : fabriquer non pas une voix qui parle à la place du vivant, mais une interface qui nous oblige à demander ce que l’autre distingue.
Conclusion : le premier contact à déjà un habitat
Earth Species Project déplace la question du langage animal. Le problème n’est plus seulement de collectionner des sons, mais de construire une chaîne commune allant de l’archive brute à l’expérience contrôlable. NatureLM-audio est une pièce majeure de cette chaîne parce qu’il rend les sons interrogeables par le langage naturel et transfère des connaissances entre espèces. Ses limites rappellent en même temps que la sortie d’un modèle n’est jamais une traduction garantie.
Le beluga du Saint-Laurent donne à cette recherche une portée concrète : écouter peut contribuer à protéger, cartographier peut révéler une culture, émettre peut aussi la perturber. Le METI terrestre a un avantage sur son analogue cosmique : nous pouvons observer les conséquences. Il a donc une responsabilité supplémentaire. Avant de parler aux étoiles, il nous apprend que tout message adressé à un autre monde devrait commencer par une discipline de l’écoute.
Références et prolongements
- Earth Species Project, documentation de NatureLM-audio et guide des capacités et limites.
- Robinson et al., NatureLM-audio: an Audio-Language Foundation Model for Bioacoustics, ICLR 2025.
- Earth Species Project, écosystème d’outils ouverts.
- Earth Species Project, appels de contact des belugas du Saint-Laurent.
- COSEPAC, structure des populations et répertoires vocaux du beluga.
- Earth Species Project, feuille de route technique et éthique des playbacks génératifs.